堆叠式自动编码器
自动编码器可以具有多个隐藏层。在这种情况下,它们被称为堆叠式自动编码器(或深度自动编码器)。添加更多的层有助于自动编码器学习更多的复杂的编码。就是说,要注意不要使自动编码器过于强大。想象一个强大的编码器,它只是学会了把每个输入映射到单个任意数字(而解码器则学习反向映射)。显然这样的自动编码器可以完美地重建训练数据,但是它不会学到任何有用的数据表征(并且不太可能将其很好地泛化到新实例中)
堆叠式自动编码器的架构典型地相对于中间隐藏层(编码层)堆成。
使用Keras实现堆叠式自动编码器
可以实现常规的深度MLP那样来实现堆叠式编码器。特别地,可以使用用于训练深度网络相同的技术。
| |
(60000, 28, 28)
Epoch 1/10
1719/1719 [==============================] - 7s 3ms/step - loss: 0.3156 - val_loss: 0.2933
Epoch 2/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.2916 - val_loss: 0.2852
Epoch 3/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.2861 - val_loss: 0.2817
Epoch 4/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.2833 - val_loss: 0.2796
Epoch 5/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.2817 - val_loss: 0.2783
Epoch 6/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.2806 - val_loss: 0.2774
Epoch 7/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.2797 - val_loss: 0.2766
Epoch 8/10
1719/1719 [==============================] - 4s 3ms/step - loss: 0.2789 - val_loss: 0.2758
Epoch 9/10
1719/1719 [==============================] - 4s 3ms/step - loss: 0.2783 - val_loss: 0.2753
Epoch 10/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.2777 - val_loss: 0.2746
- 将自动编码器模型分为两个字模型:编码器和解码器
- 编码器使用$28\times28$像素的灰度图像,先将它们展平,以便每个图像表示为大小784的向量,然后通过两个尺寸递减的Dense层(100个神经元然后是30个)来处理这些向量,两个都使用GELU激活函数。对于每个输入图像,编码器输出大小为30的向量
- 解码器使用大小为30的编码(由编码器输出),并通过两个大小递增的Dense层(100个神经元然后784个)来处理它们,并将最终向量重构为$28\times28$的数组,因此解码器的输出具有与编码器输入相同的形状
- 在编译堆叠式自动编码器时,使用二元交叉熵损失代替均方误差。将重建任务视为多标签二元分类问题:每个像素强度代表像素应为黑色的概率,以这种方法(而不是回归问题)往往会使得模型收敛得更快
- 最后,使用X_train作为输入和目标来训练函数(类似地,使用X_valid作为验证输入和输出目标)
可视化重构
确保对自动编码器进行了恰当训练的一种方法是比较输入和输出:差异不应该很明显。
| |
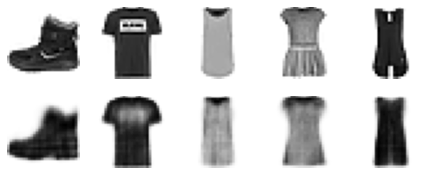
重构是可识别的,但损失有点大,可能需要训练模型更持久一点,或者使编码器和解码器更深,或者使编码更大。但是,如果使网络过于强大,它就能够在没有学习到数据中任何有用模式的情况下,进行完美的重构
可视化Fashion MNIST数据集
现在已经训练了一个堆叠式自动编码器,可以使用它来减少数据集的维度。对于可视化而言,与其他降维算法相比,它并没有给出很好的结果,但是自动编码器的一大优势是它们可以处理具有许多实例和许多特征的大型数据集。因此,一种策略是使用自动编码器将维度降低到合理水平,然后使用另一维降维算法进行可视化。以下使用这种策略来可视化Fashion MNIST
首先,使用堆叠式自动编码器中的编码器将维度缩小到30,然后使用Scikit-Learn中的t-SNE算法的实现将维度减小到2来进行可视化:
| |
C:\ProgramData\Miniconda3\envs\tf2\lib\site-packages\sklearn\manifold\_t_sne.py:780: FutureWarning: The default initialization in TSNE will change from 'random' to 'pca' in 1.2.
  warnings.warn(
C:\ProgramData\Miniconda3\envs\tf2\lib\site-packages\sklearn\manifold\_t_sne.py:790: FutureWarning: The default learning rate in TSNE will change from 200.0 to 'auto' in 1.2.
  warnings.warn(

<matplotlib.collections.PathCollection at 0x2324edf9820>
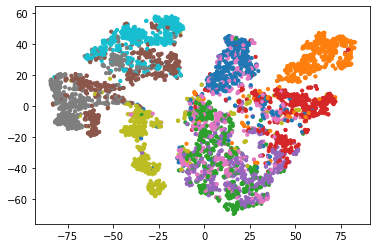
t-SNE算法识别出几个与类合理匹配的集群(每个类用不同颜色表示)
自动编码器可用于降维。另一个应用是无监督学习
使用堆叠式自动编码器的无监督预训练
如果要处理一个复杂的有监督任务,但是没有很多标记好的数据,一种解决方案是找到执行类似任务的神经网络并重用其较低层网络。这样就可以使用很少的训练数据来训练一个高性能的模型,因此神经网络不必学习所有的底层特征,它只会重用现有网络学到的特征检测器
同样,如果有一个大型数据集,但大多数未被标记,可以先使用所有数据训练一个堆叠的自动编码器,然后重用较低层为实际任务创建神经网络,并使用标记的数据对其进行训练。
实现:适用所有训练数据(标记的和未标记的)来训练自动编码器,然后重用其编码器层来创建一个新的神经网络
绑定权重
当一个自动编码器整齐对称时,一种常见的技术是将解码器层的权重与编码器层的权重绑定起来。这样可以将模型中权重的数量减少一半,从而加快训练速度并降低过拟合的风险。具体来说,如果自动编码器有N层(不算输入层),并且$W_L$表示第$L$层的连接权重,解码器层可以简单定义为$W_{N-L+1}=W_L^T$(其中,$L=1,2,\dots,N/2)$
| |
这个自定义层的作用类似于常规的Dense层,但是它使用了另一个Dense层的权重,并对它进行了转置(设置transpose_b=True等效于转置第二个参数,但是它的效率更高,因为它可以在matmul()操作中即时执行转置)。但是,它使用自己的偏置向量,接下来,可以创建一个新的堆叠式自动编码器,和前一个非常相似,但是将解码器的Dense绑定到了编码器的密集层
| |
Epoch 1/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.6947 - val_loss: 0.4871
Epoch 2/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.4224 - val_loss: 0.3859
Epoch 3/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.3779 - val_loss: 0.3609
Epoch 4/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.3565 - val_loss: 0.3362
Epoch 5/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.3400 - val_loss: 0.3309
Epoch 6/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.3319 - val_loss: 0.3201
Epoch 7/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.3360 - val_loss: 0.3591
Epoch 8/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.3279 - val_loss: 0.3173
Epoch 9/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.3215 - val_loss: 0.3300
Epoch 10/10
1719/1719 [==============================] - 5s 3ms/step - loss: 0.3327 - val_loss: 0.3436
与前一个模型相比,该模型的参数数量减少了几乎一半
一次训练一个自动编码器
与其像一次训练整个堆叠式自动编码器那样,不如一次训练一个浅层自动编码器,然后将它们全部堆叠成一个堆叠式自动编码器
在训练的第一阶段,第一个自动编码器学习重建输入。然后,使用第一个自动编码器对整个训练集进行编码,这提供了一个新的(压缩)训练集。然后,在此新的数据集上训练第二个自动编码器,这是训练的第二阶段。最后,使用所有这些自动编码器来构建堆叠式自动编码器