循环自动编码器
如果要为序列构建自动编码器,例如时间序列和文本(例如,用于无监督学习或降维),那么递归神经元可能比密集网络更合适。构建循环自动编码器非常简单直接:编码器通常是序列到向量的RNN,它将输入序列压缩为单个向量。解码器是向量到序列RNN,做相反的处理:
| |
Epoch 1/10
1719/1719 [==============================] - 23s 11ms/step - loss: 0.3433 - val_loss: 0.3127
Epoch 2/10
1719/1719 [==============================] - 19s 11ms/step - loss: 0.3047 - val_loss: 0.2962
Epoch 3/10
1719/1719 [==============================] - 19s 11ms/step - loss: 0.2943 - val_loss: 0.2896
Epoch 4/10
1719/1719 [==============================] - 18s 11ms/step - loss: 0.2881 - val_loss: 0.2832
Epoch 5/10
1719/1719 [==============================] - 19s 11ms/step - loss: 0.2841 - val_loss: 0.2795
Epoch 6/10
1719/1719 [==============================] - 19s 11ms/step - loss: 0.2812 - val_loss: 0.2769
Epoch 7/10
1719/1719 [==============================] - 19s 11ms/step - loss: 0.2790 - val_loss: 0.2747
Epoch 8/10
1719/1719 [==============================] - 19s 11ms/step - loss: 0.2773 - val_loss: 0.2733
Epoch 9/10
1719/1719 [==============================] - 19s 11ms/step - loss: 0.2757 - val_loss: 0.2723
Epoch 10/10
1719/1719 [==============================] - 18s 10ms/step - loss: 0.2745 - val_loss: 0.2711
这种循环自动编码器可以处理任何长度的序列,每个时间步长都具有28个维度,这意味着它可以通过把每个图像视为一系列的行来处理Fashion MNIST图像:在每个时间步长,RNN都将处理一个28像素的行,显然可以对任何类型的序列使用循环自动编码器。在这里使用RepeatVector层作为编码器的第一层,以确保其输入向量在每个时间步长都馈送到解码器
可视化重构
| |
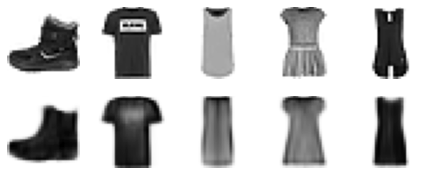
为了强制自动编码器学习有趣的特征,我们限制了编码层的大小,使其成为不完整自动编码器,实际上,还有许多其它类型的约束可以使用,包括使编码层与输入层一样大甚至更大,从而成为一个完整自动编码器